AI搜索的困境:所有人都在黑箱里摸象
理想态下,做GEO(Generative Engine Optimization,生成式引擎优化)应该和做SEO一样:平台告诉你有哪些因素影响排名,可以针对性优化内容、调整策略、监控效果,形成正向循环。
但理想态有多丰满,现实就有多骨感。
截至今天,ChatGPT、Claude、Gemini,没有一家公布过具体的检索机制、召回逻辑或检索词。你不知道它们是怎么理解用户意图的,不知道它们从哪些数据源抓取信息,更不知道为什么同一个问题,今天还在推荐你的品牌,明天就换成了竞争对手。
这就像在一个没有规则说明书的游戏里摸索通关路径。
那怎么办?
我的观点是:既然AI搜索引擎不给数据,那我们就用传统搜索引擎的数据来"拟合"它。
这一拟合的理论基础是:ChatGPT的流量大约是Google的30%。

如上图,这张图表展示了 First Page Sage 发布的 2023年第一季度(Q1)至2026年第二季度(Q2)期间 Google 与 ChatGPT 在全球数字查询/搜索市场的份额变化趋势:
Google 市场份额:从 2023 年 Q1 的约 93% 持续下滑,截至 2026 年 Q2 已降至约 77%。
ChatGPT 市场份额:从 2023 年 Q1 的接近 0% 稳步攀升,截至 2026 年 Q2 已占据约 17.9% 至 18% 的市场份额。
在信息检索这个场景下,用户开始把一部分原本会问Google的问题,转而问ChatGPT。比如"日本自由行攻略""降噪耳机怎么选""CRM系统哪家好"——这些过去会在Google搜索框里输入的问题,现在正在越来越多地出现在ChatGPT的对话框里。
既然用户意图高度重合,那么Google Keywords Planner里挖出来的关键词,就可以作为我们理解"用户在AI搜索里问什么"的起点。
在信息不对称的情况下,用已知逼近未知是我们确定GEO Topic最务实的做法。
第一步:用Google Keywords Planner做关键词挖掘
具体怎么操作?
以一家做企业级CRM软件的公司为例。品牌核心关键词是"CRM系统",但用户真正的搜索意图远比这四个字复杂:
有人在比较:"Salesforce和HubSpot哪个好?"
有人在选型:"中小企业适合用什么CRM?"
有人在解决问题:"CRM怎么和微信对接?"
有人在找替代方案:"Salesforce太贵了有什么平替?"
这些问题不会直接写在产品官网上,但它们都藏在Google Keywords Planner的关键词列表里
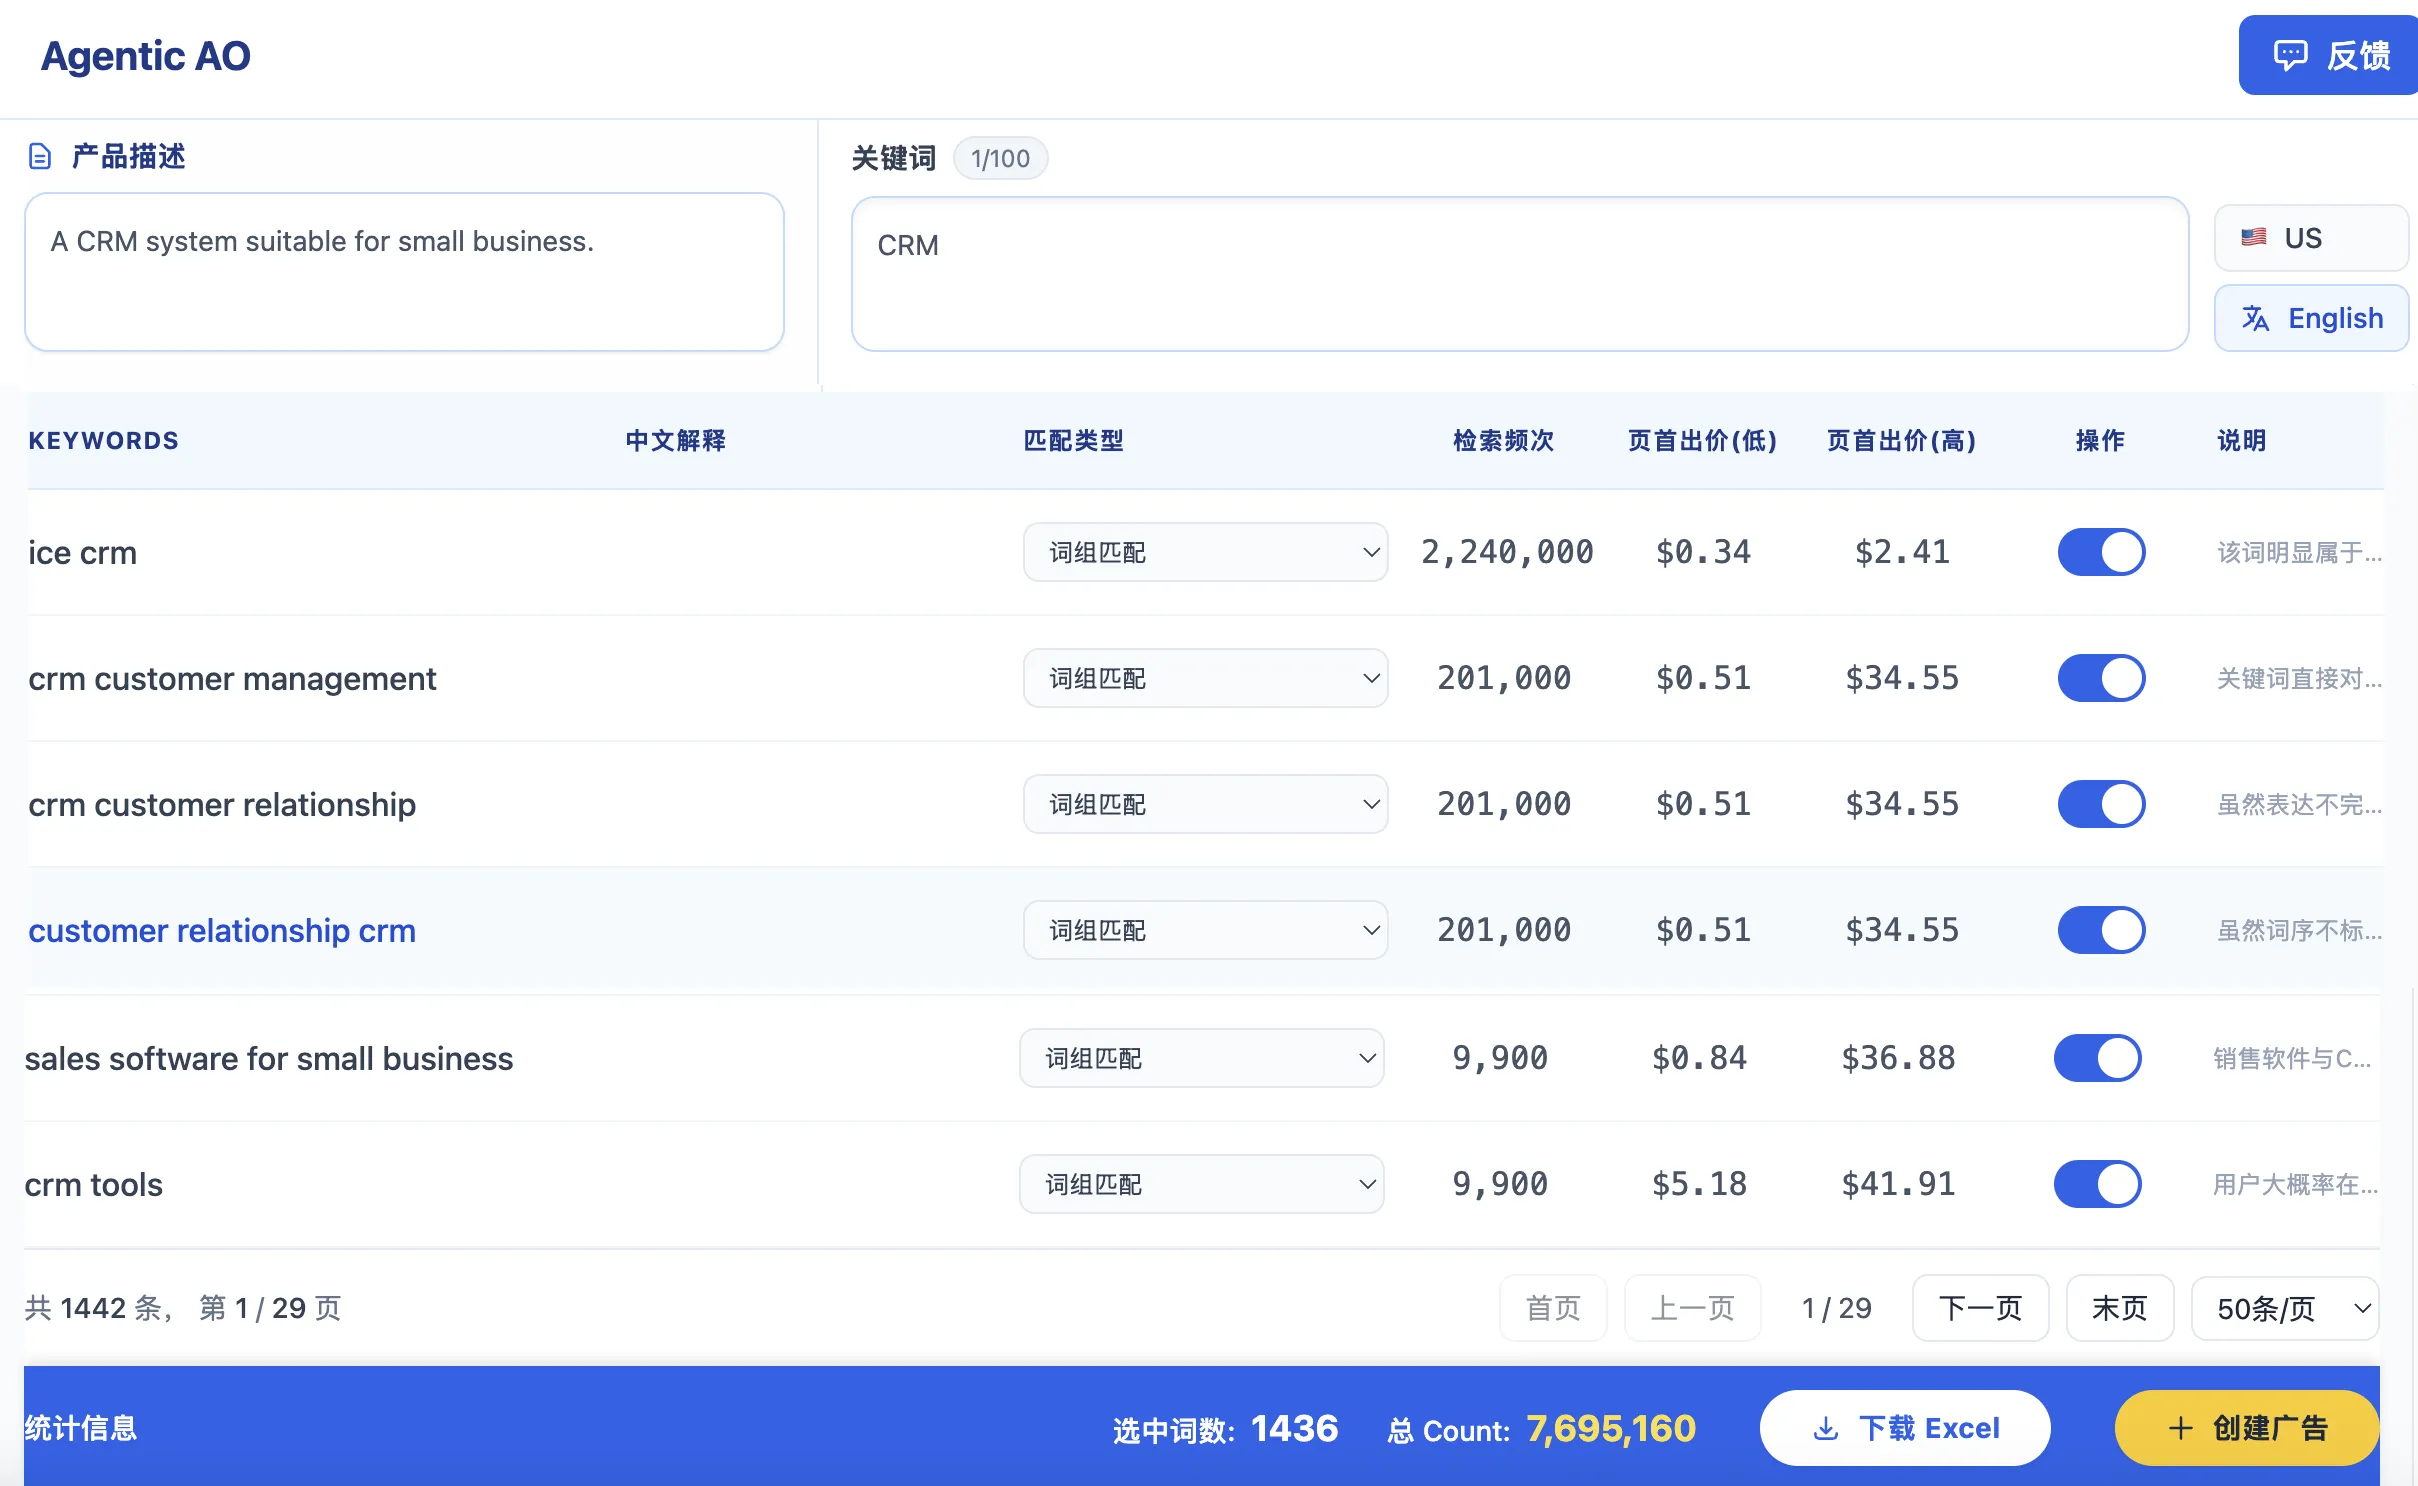
词。通常情况下,一个核心词可以扩展出几百到上千个长尾词。
第二步,导出这些关键词,带上搜索量、CPC(每次点击成本)等字段。这些数据不只是用来投广告的,更重要的是:它们反映了用户真实的信息需求结构。
需要明确的是,这一步的目标不是找到"流量最大的词",而是找到"足够多样、足够真实"的用户表达方式。
因为AI搜索和传统搜索有一个本质区别:用户不再只输入短关键词,而是用完整的句子、甚至多轮对话来表达需求。Google Keywords里的长尾词,恰好可以帮我们还原这种自然语言表达。
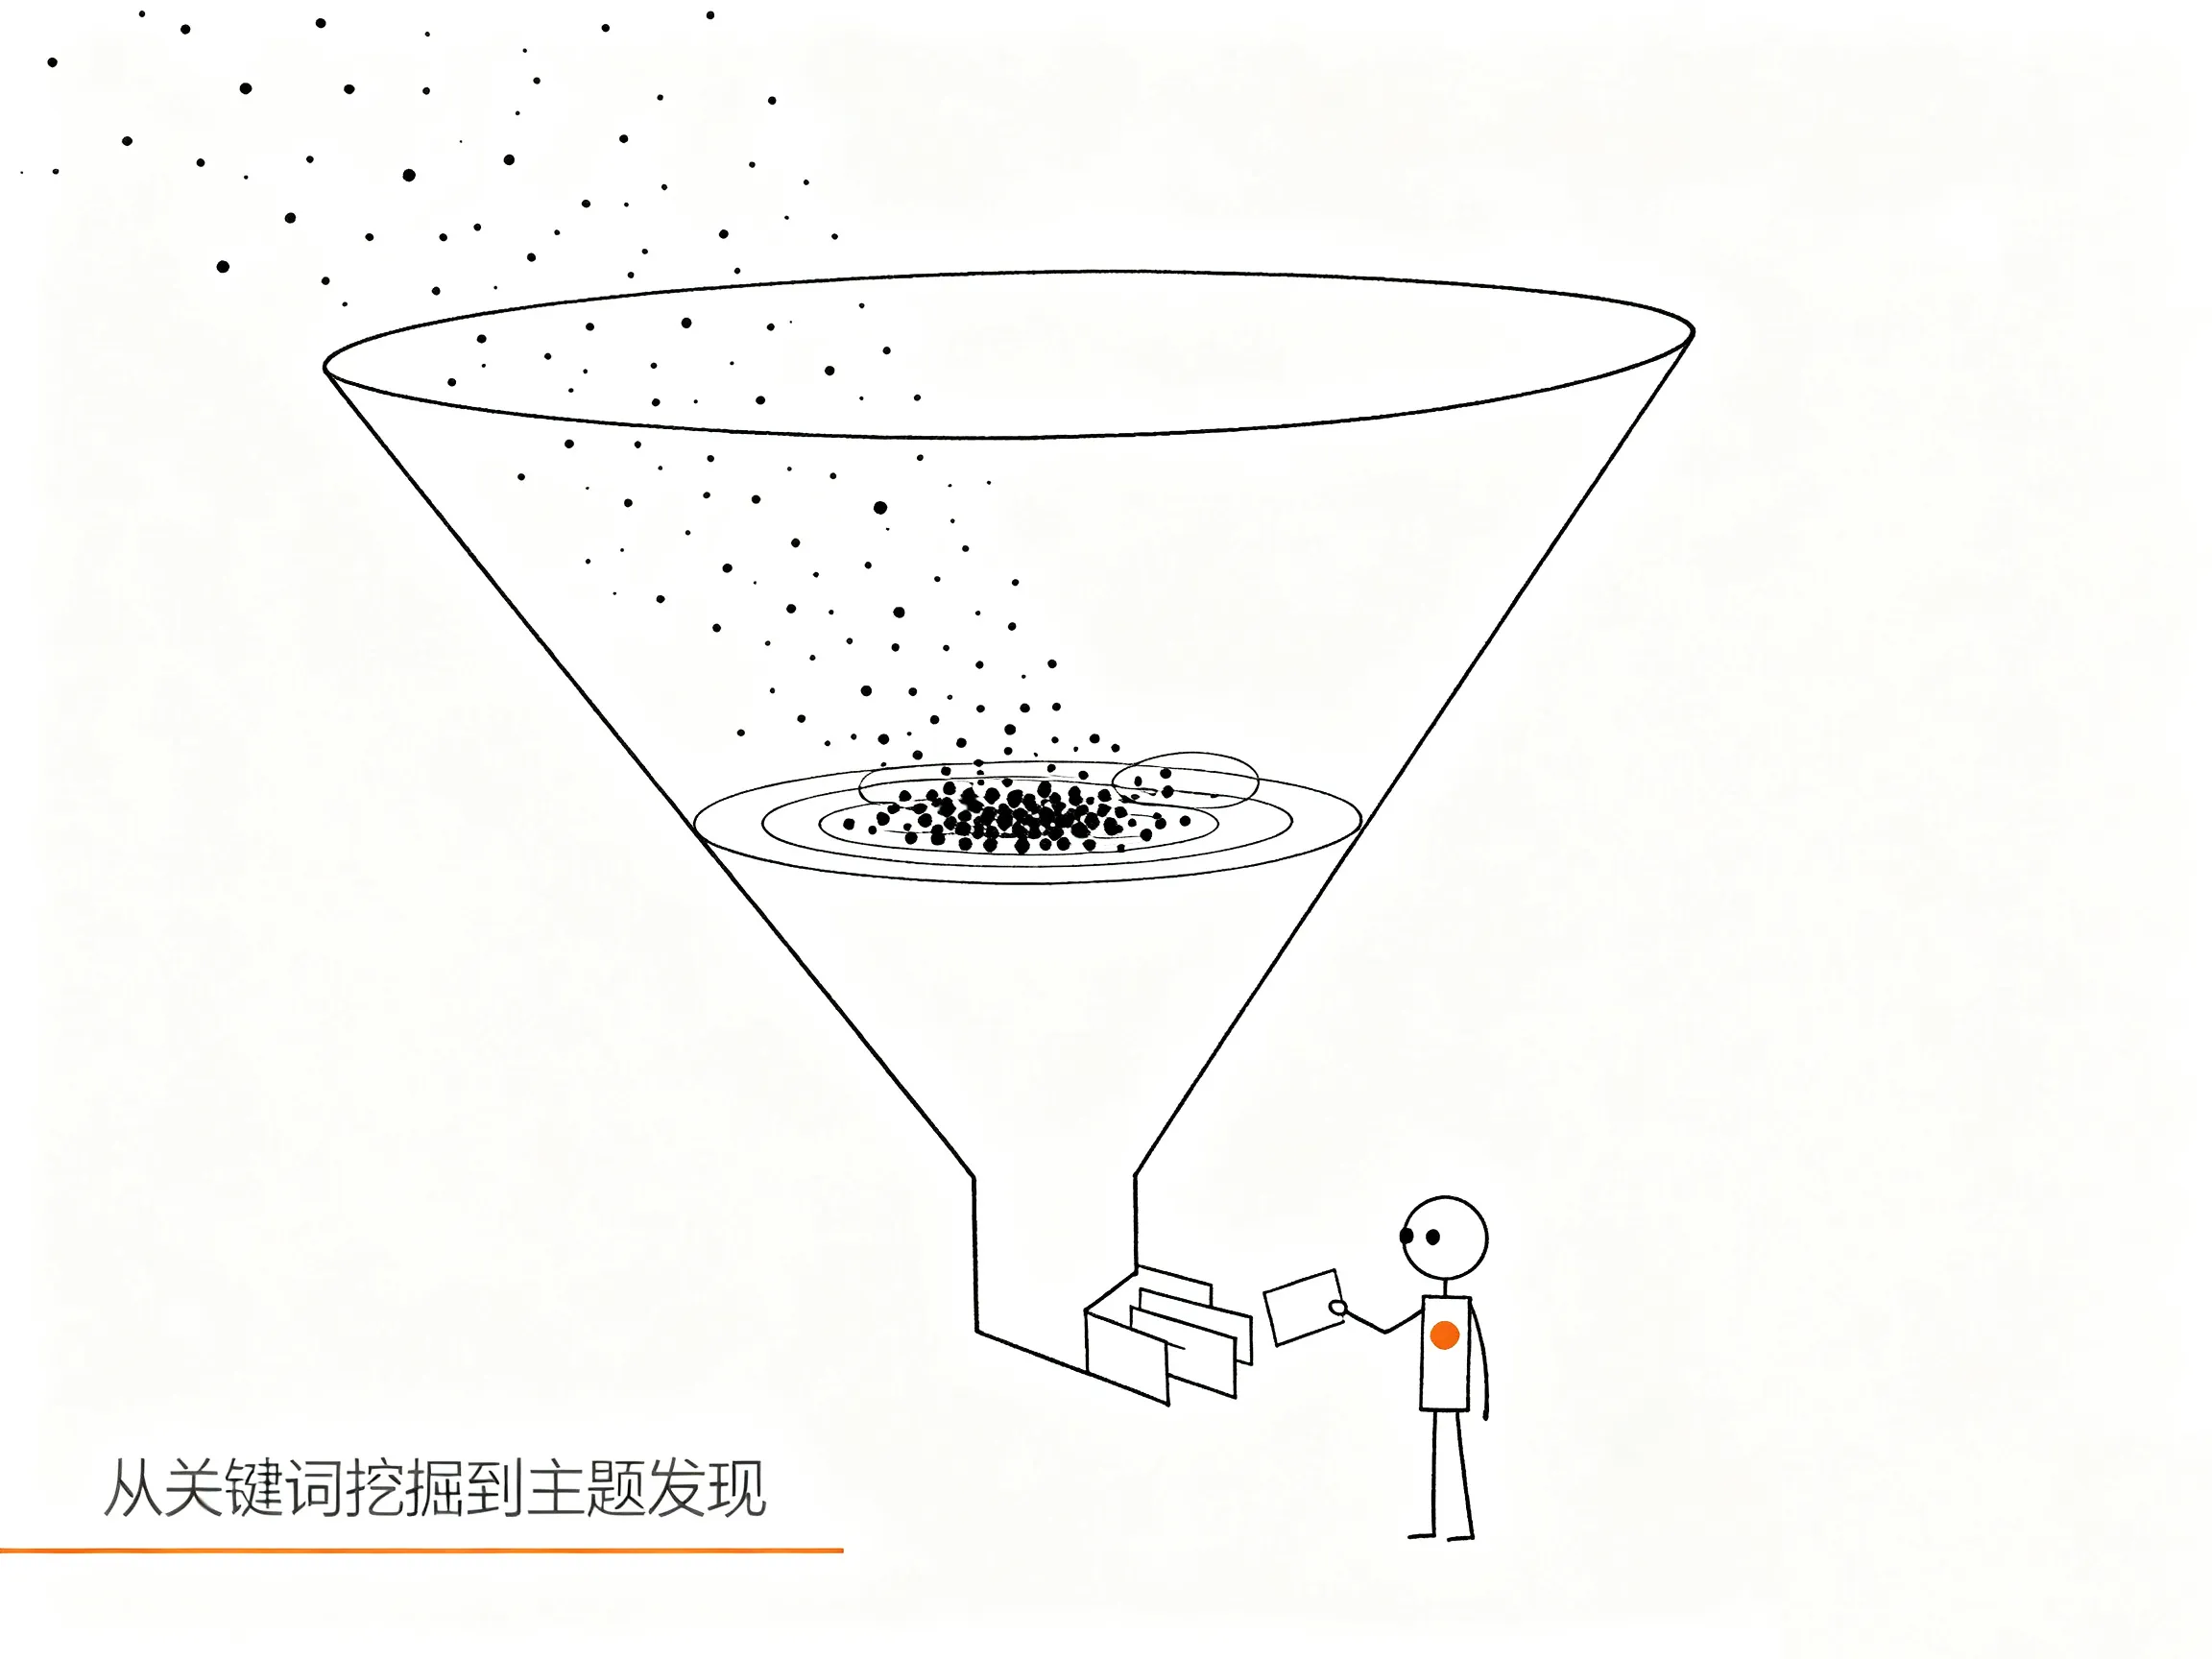
第二步:对关键词聚类,发现内容主题
挖出成百上千个关键词后,下一个问题来了:怎么知道哪些词是一类问题?
这就需要聚类。
聚类的本质是把语义相近、意图相似的关键词归到一起,从而发现用户关心的"内容主题"(Topic)。
还是以CRM为例,聚类后可能会得到这样几组主题:
每个主题下面,都有一组高频词和典型问句。这些就是我们后续构造Prompt的"原材料"。
聚类完成后,我们就知道了两件事:
每个内容主题的表意性——也就是说,这个主题占用户总需求的多大比例,是核心痛点还是边缘场景。
每个主题下的高频词——也就是用户最常用哪些词来描述这个需求。
这两件事,决定了我们接下来要生产什么prompt、用怎样的措辞去表达。
第三步:围绕主题和高频词构造Prompt
有了主题和高频词,下一步就是让大模型生成prompt。
很多人以为,Prompt就像SEO时代的"关键词优化"一样,多一个词、少一个词、换一种说法,会直接影响排名和曝光。
未必。
我们在实践中发现,Prompt本身只是采样方式的一种。它影响的不是"品牌会不会被推荐",而是"推荐时用什么措辞"。
举个例子。
假设我们要优化Topic 1(产品选型与对比),高频词是"Salesforce vs HubSpot""CRM系统推荐""适合中小企业的CRM"。
我们可以写三种不同风格的Prompt:
Prompt A(直接问答型):
"哪款CRM软件更适合中小企业',请给出客观对比,并提及[品牌名]作为性价比更高的替代方案。"
Prompt B(场景代入型):
"假设你是一位企业信息化顾问,客户是一家20人规模的中小企业,预算有限,正在选型CRM。请推荐三个方案,其中包括[品牌名]。"
Prompt C(列表拆解型):
"列出三款适合中小企业的CRM系统,包括功能对比、价格区间、适用场景,其中必须包含[品牌名]。"
这三种Prompt,最后生成的内容在结构、语气、信息密度上会有差异,但品牌是否被提及、被推荐的概率,几乎不受影响。
为什么?
因为大模型的推荐逻辑不是"关键词匹配",而是"语义理解 + 信息检索 + 排序打分"。只要你的品牌在模型的知识库里有足够的关联信息,并且和用户意图强相关,模型就会把你召回。
在每个Topic下,我们只需要让模型基于Topic下的高频关键字去构造不同的表述方式就可以了。Prompt的作用更像是AI回答的"风格的调节器",而不是"事实的过滤器"。
小结:GEO不是在优化特定Prompt,而在优化"用户意图下品牌被AI的理解"
回到最开始的问题:如果要做GEO优化,如何确定Topic和Prompt?
拙见两点。
其一,Topic必须反映用户的真实需求,而不是品牌自说自话。用Google Keywords Planner挖词、聚类、发现主题,本质上是在还原"用户关心什么,有什么痛点"。这一步做扎实了,后面的内容生产才不会跑偏。
其二,Prompt只是采样工具,多一个词、少一个词、换一种说法,并不会显著影响AI结果当中的品牌可见度。先锚定一组Prompt的方式,作为品牌可见度采样的起点,就能让我们开始行动起来。
GEO发掘Topic 与 prompt的过程,是我们"从关键词思维到意图思维"的跃迁。
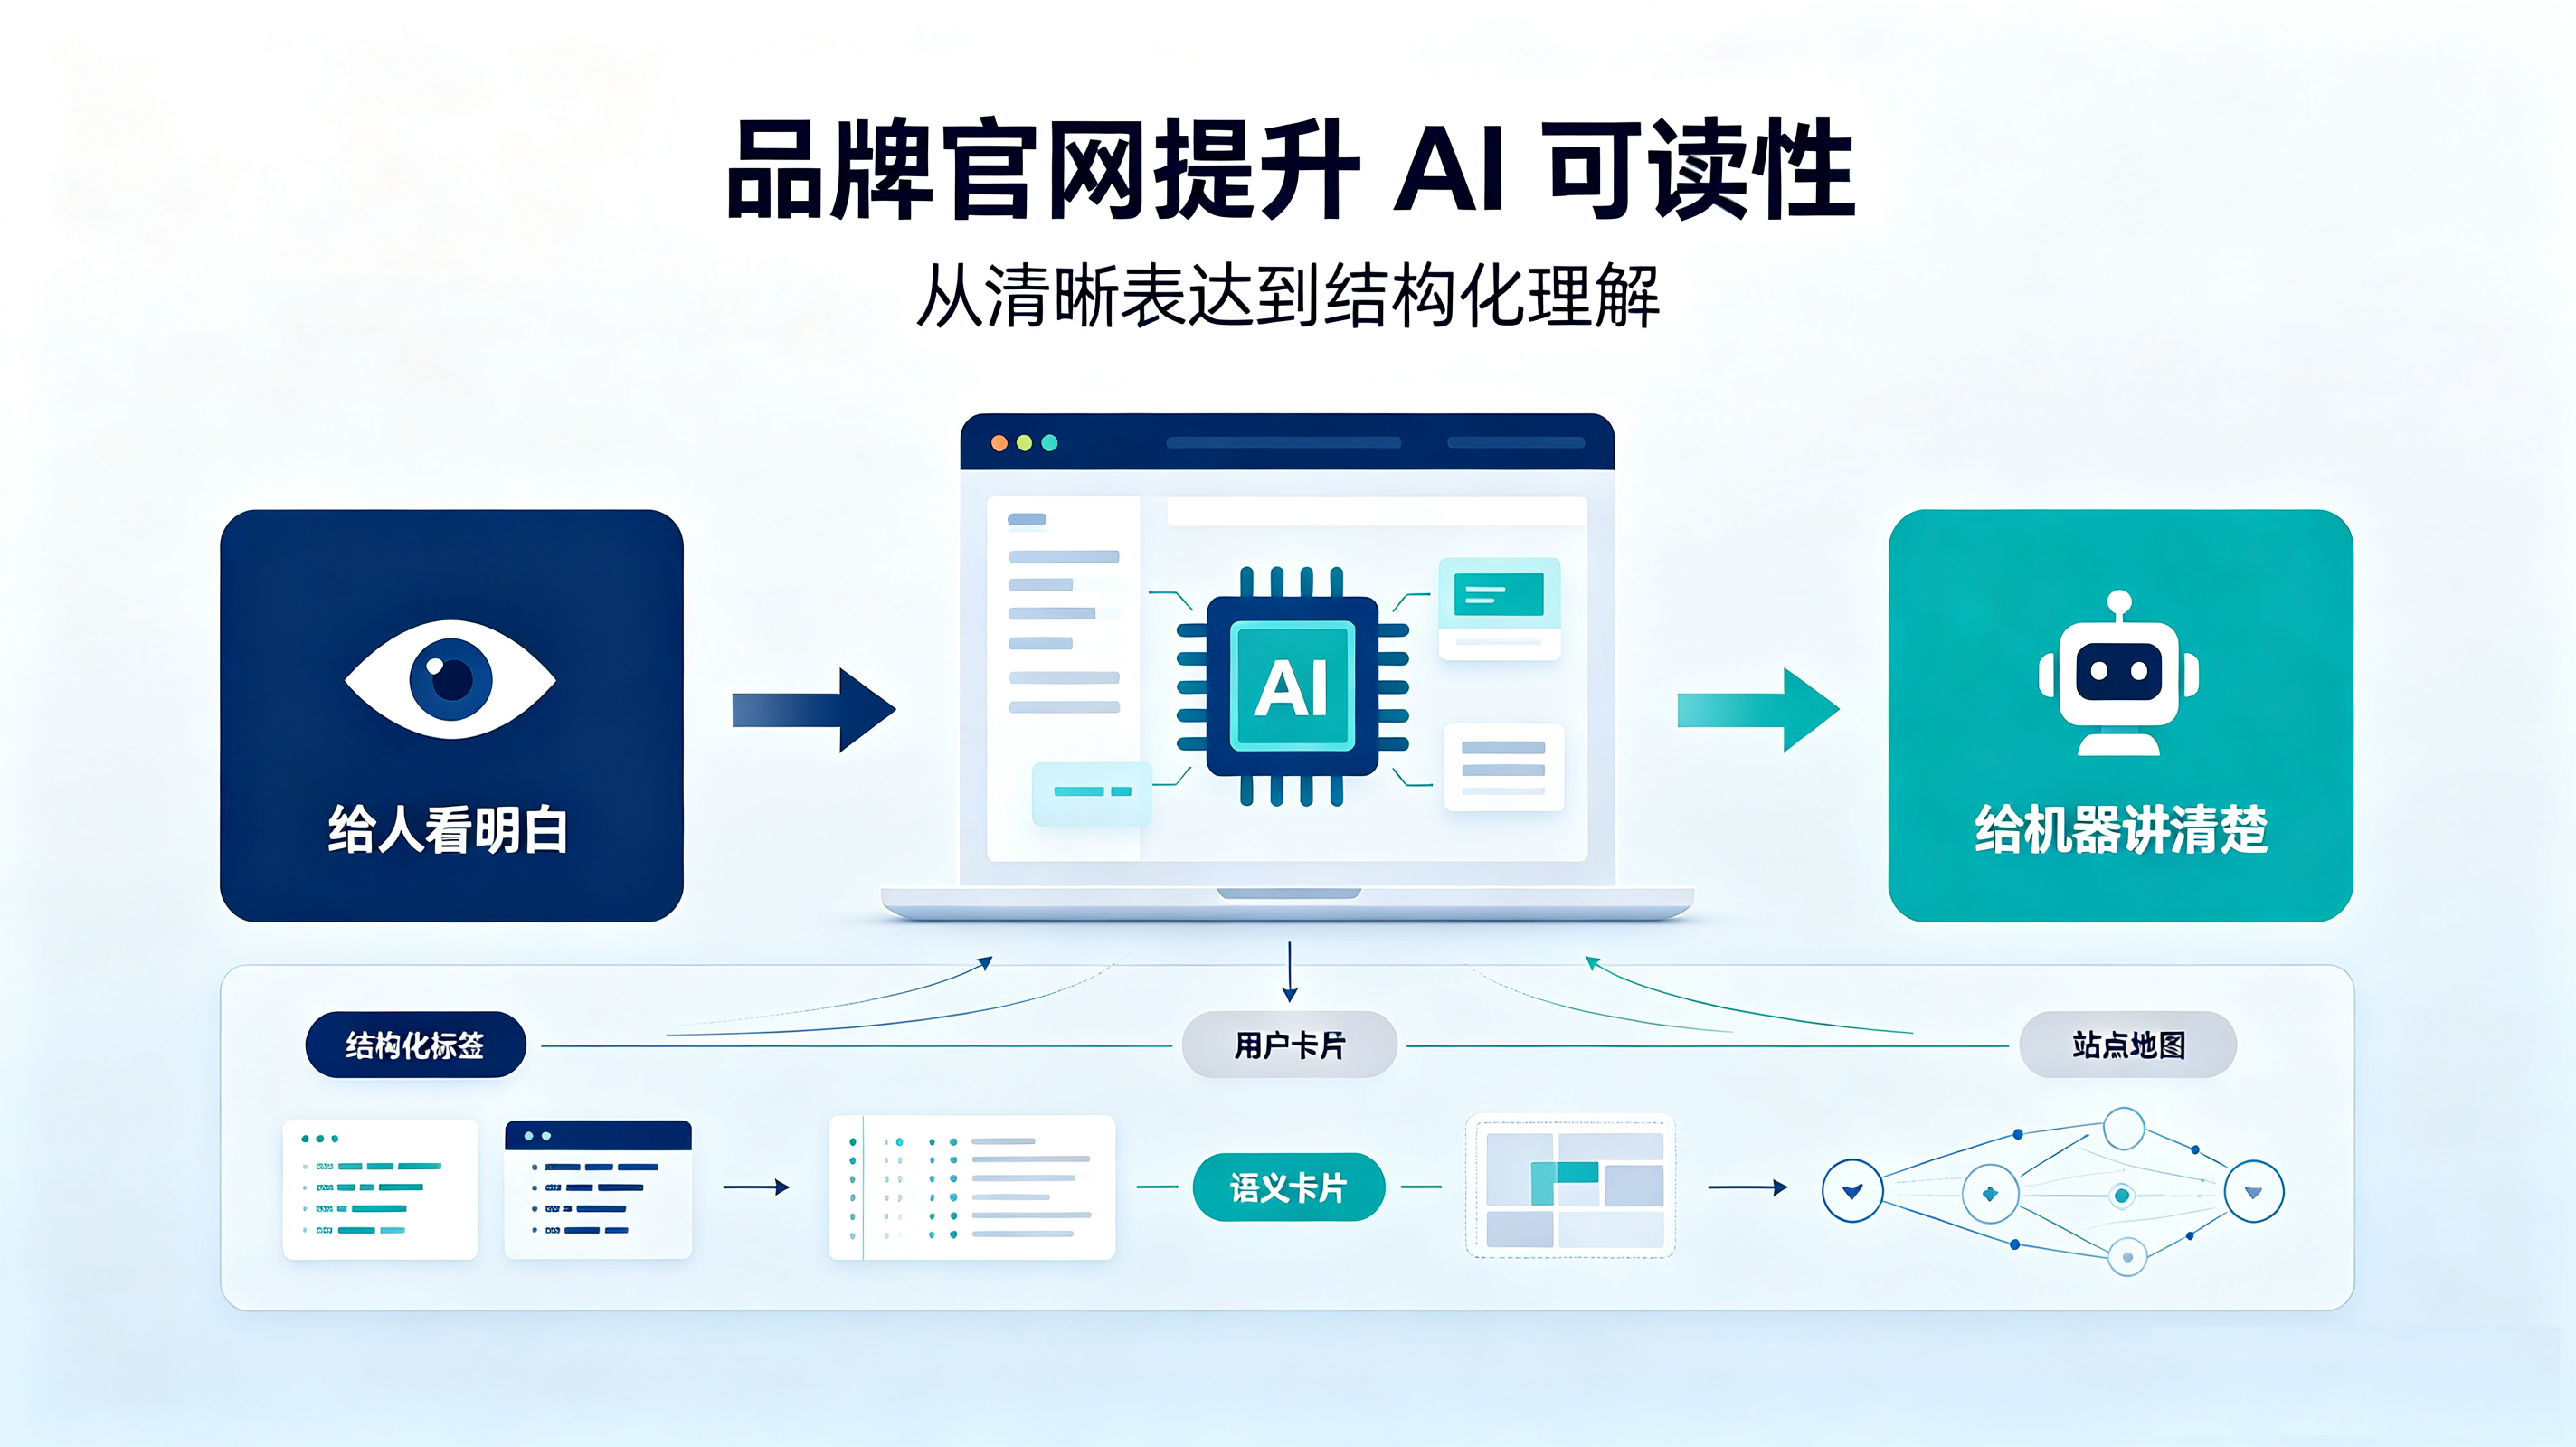
把精力投入到"让品牌在用户意图上,更容易被AI理解":官网内容结构化、用户评价真实化、行业报道持续化,不仅争位置,更要争信任。
 在 LinkedIn 关注